


Neste artigo
- Como funciona uma simulação de Monte Carlo?
- Exemplo: qual a chance de dois dados somarem 7?
- Quantas repetições são necessárias?
- Como estimar o valor de pi com sorteios?
- Aí você pergunta: se existe fórmula, por que simular?
- Como fica em PHP e em C?
- De onde vem o nome Monte Carlo?
- Quais são os erros mais comuns em simulações?
- Agora é com você!
Simulação de Monte Carlo é um método que usa sorteios, repetidos milhares de vezes, para estimar um resultado que seria difícil de calcular por fórmula. Em vez de resolver a conta, você repete o experimento no computador e observa com que frequência cada coisa acontece.
No artigo sobre números aleatórios e semente, você aprendeu a sortear e a repetir o mesmo sorteio. Agora vem o uso mais valioso disso. Daqui para frente, os artigos de estatística desta jornada apresentam uma fórmula e, logo depois, conferem a fórmula com uma simulação de 10.000 repetições. É o método de Monte Carlo trabalhando. E ele tem uma história curiosa: nasceu dentro de um laboratório de pesquisa nuclear e ganhou o nome de um cassino.
Quer saber se uma moeda é honesta? Você não precisa estudar o metal nem o formato. Joga a moeda mil vezes e conta as caras. Se saíram perto de 500, tudo certo. Se saíram 800, tem coisa errada. Monte Carlo é isso, com o computador jogando a moeda por você.
Como funciona uma simulação de Monte Carlo?
Em quatro passos:
- Descreva o experimento. O que acontece em uma rodada? Por exemplo: lançar dois dados.
- Sorteie. Use números aleatórios para fazer uma rodada.
- Repita. Milhares de vezes, anotando o que aconteceu em cada uma.
- Conte. A proporção de rodadas em que o evento aconteceu é a estimativa da probabilidade.
Exemplo: qual a chance de dois dados somarem 7?
Esse caso tem resposta exata, o que é ótimo para testar o método. Das 36 combinações possíveis de dois dados, 6 somam 7. A probabilidade é 6 ÷ 36, cerca de 0,1667. Agora a simulação:
import random

random.seed(42)

repeticoes = 10000
sucessos = 0

for _ in range(repeticoes):
    dado1 = random.randint(1, 6)
    dado2 = random.randint(1, 6)
    if dado1 + dado2 == 7:
        sucessos += 1

print(sucessos)
print(sucessos / repeticoes)
print(6 / 36)
Saída:
1704
0.1704
0.16666666666666666
Em 10.000 rodadas, a soma 7 saiu 1.704 vezes. A estimativa, 0,1704, ficou a menos de meio ponto percentual do valor exato. E em nenhum momento o programa precisou saber que existem 36 combinações. Sacou a ideia? A simulação chega perto da resposta só de observar.
Quantas repetições são necessárias?
Quanto mais, melhor. Mas com um detalhe importante sobre o ritmo. Este programa mostra a estimativa em cinco momentos, de 100 a 1 milhão de repetições:
import random

random.seed(42)

sucessos = 0
for repeticao in range(1, 1000001):
    if random.randint(1, 6) + random.randint(1, 6) == 7:
        sucessos += 1
    if repeticao in (100, 1000, 10000, 100000, 1000000):
        estimativa = sucessos / repeticao
        print(repeticao, round(estimativa, 4), round(abs(estimativa - 1 / 6), 4))
Saída:
100 0.24 0.0733
1000 0.16 0.0067
10000 0.1704 0.0037
100000 0.1646 0.0021
1000000 0.1663 0.0004
| Repetições | Estimativa | Distância do valor exato |
|---|---|---|
| 100 | 0,2400 | 0,0733 |
| 1.000 | 0,1600 | 0,0067 |
| 10.000 | 0,1704 | 0,0037 |
| 100.000 | 0,1646 | 0,0021 |
| 1.000.000 | 0,1663 | 0,0004 |
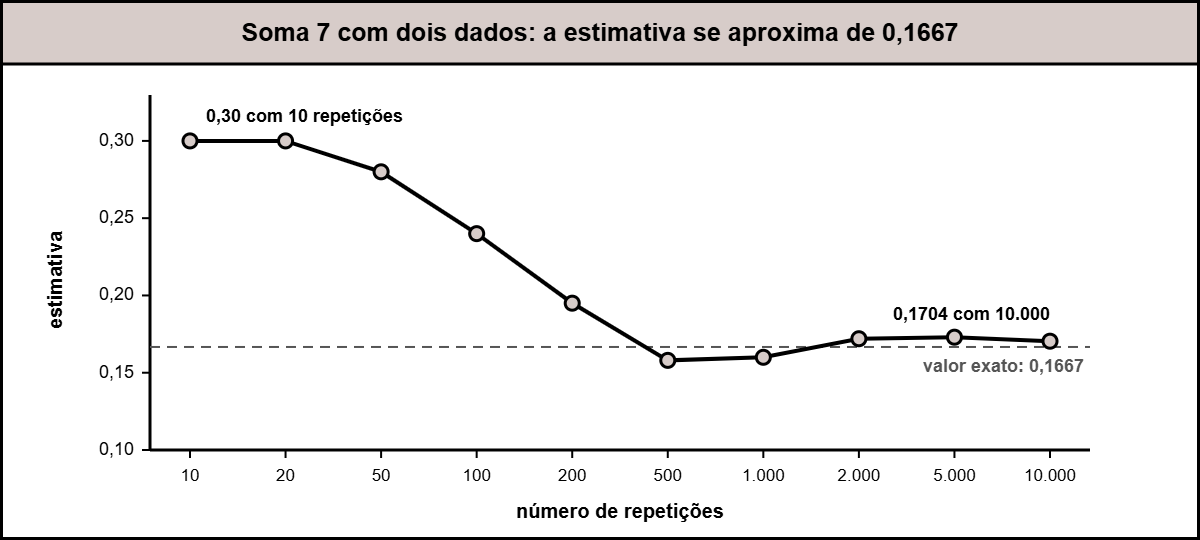
Com 100 repetições, a estimativa errou feio. Com 1 milhão, acertou três casas. O resultado matemático por trás disso é a lei dos grandes números, que um material de aula da UFRJ apresenta como a base teórica do método: a média das repetições se aproxima do valor verdadeiro conforme o número de repetições cresce.
Agora o detalhe do ritmo: o erro típico cai com a raiz quadrada do número de repetições. Para ganhar uma casa decimal de precisão, não basta dobrar o trabalho. É preciso multiplicar por 100. O mesmo material comenta que esse ritmo não é dos mais rápidos.
ATENÇÃO: o que diminui é o erro típico, e não cada erro individual. Em outra semente, a estimativa com 10.000 repetições poderia ter ficado mais longe do alvo que a de 1.000. A tendência só aparece no conjunto.
Como estimar o valor de pi com sorteios?
Este é o exemplo clássico. Desenhe um quadrado de lado 1 e, dentro dele, um quarto de círculo de raio 1. A área do quarto de círculo é π ÷ 4. Se você sortear pontos ao acaso dentro do quadrado, a fração que cai dentro do quarto de círculo fica perto de π ÷ 4. Multiplicando por 4, sai uma estimativa de π:
import random

random.seed(42)

pontos = 10000
dentro = 0

for _ in range(pontos):
    x = random.random()
    y = random.random()
    if x * x + y * y <= 1:
        dentro += 1

print(dentro)
print(4 * dentro / pontos)
Saída:
7815
3.126
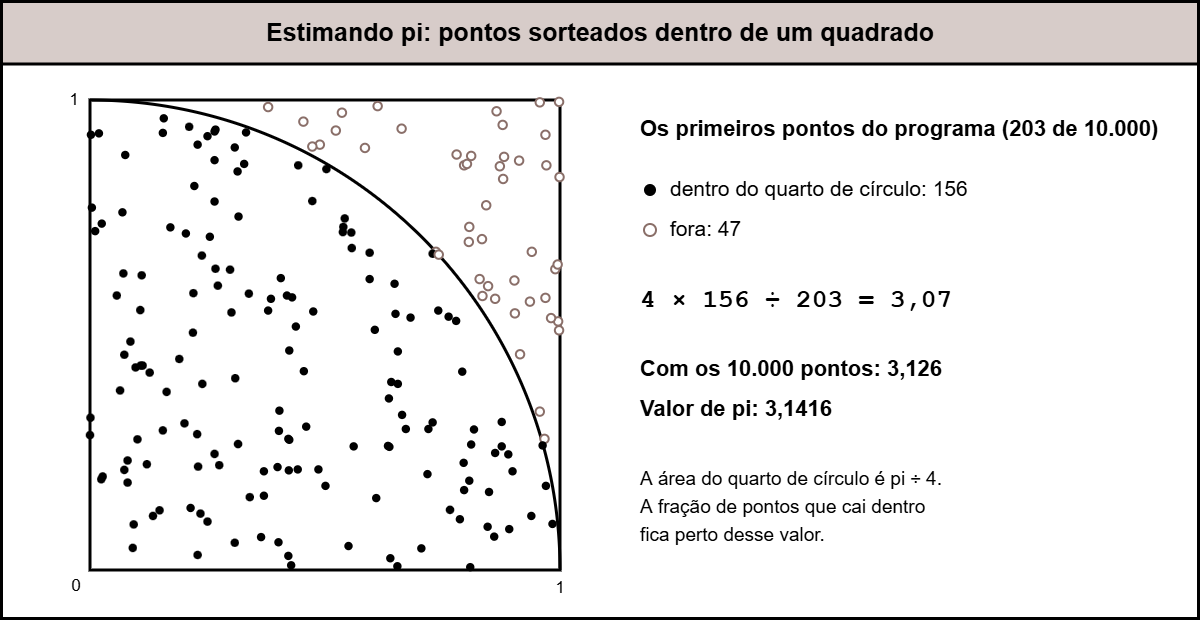
Dos 10.000 pontos, 7.815 caíram dentro. A estimativa foi 3,126, contra o valor real de 3,1416. Ninguém calcula π desse jeito na prática, porque existem métodos muito melhores. Mas o exemplo mostra o alcance da ideia: uma pergunta de geometria respondida com sorteio.
Aí você pergunta: se existe fórmula, por que simular?
Por três motivos. Primeiro, para conferir: se a fórmula e a simulação discordam, uma das duas está errada, e descobrir qual é um ótimo jeito de aprender. Segundo, porque às vezes a conta existe, mas é trabalhosa. Terceiro, porque muitos problemas reais simplesmente não têm fórmula.
Um exemplo do segundo caso. Em uma sala com 23 pessoas, qual a chance de pelo menos duas fazerem aniversário no mesmo dia? A intuição costuma dizer que é pequena. A simulação responde em poucas linhas:
import random

random.seed(42)

repeticoes = 10000
com_coincidencia = 0

for _ in range(repeticoes):
    aniversarios = [random.randint(1, 365) for _ in range(23)]
    if len(set(aniversarios)) < 23:
        com_coincidencia += 1

print(com_coincidencia / repeticoes)
Saída:
0.5128
Mais da metade! O valor exato, calculado pela fórmula, é 0,5073. A simulação chegou a 0,5128 sem que fosse preciso montar a conta. A linha que sorteia os 23 aniversários usa list comprehension.
Como fica em PHP e em C?
O exemplo dos dois dados, em PHP:
<?php

mt_srand(42);

$repeticoes = 10000;
$sucessos = 0;

for ($i = 0; $i < $repeticoes; $i++) {
    if (mt_rand(1, 6) + mt_rand(1, 6) === 7) {
        $sucessos++;
    }
}

echo $sucessos / $repeticoes, "\n";
Saída:
0.1694
E em C:
#include <stdio.h>
#include <stdlib.h>

int main(void)
{
    int repeticoes = 10000;
    int sucessos = 0;

    srand(42);

    for (int i = 0; i < repeticoes; i++) {
        int dado1 = rand() % 6 + 1;
        int dado2 = rand() % 6 + 1;
        if (dado1 + dado2 == 7) {
            sucessos++;
        }
    }

    printf("%.4f\n", (double) sucessos / repeticoes);
    return 0;
}
Saída:
0.1675
Três linguagens, três estimativas: 0,1704, 0,1694 e 0,1675. Todas perto de 0,1667 e nenhuma igual à outra, porque cada linguagem tem o seu gerador de números aleatórios. Foque no conceito, e não na linguagem!
De onde vem o nome Monte Carlo?
De um cassino. O método foi concebido em 1946 pelo matemático Stanislaw Ulam, no laboratório de Los Alamos, nos Estados Unidos, e desenvolvido com John von Neumann e outros colegas para cálculos da pesquisa nuclear. Segundo o relato publicado pelo próprio laboratório, quem batizou o método foi o físico Nick Metropolis. O nome lembrava um tio de Ulam, que pedia dinheiro emprestado à família porque “precisava ir a Monte Carlo”, a cidade dos cassinos.
Quais são os erros mais comuns em simulações?
- Usar poucas repetições. Com 100 rodadas, o exemplo dos dados errou por mais de 7 pontos percentuais.
- Tratar a estimativa como valor exato. 0,1704 não é a probabilidade. É uma aproximação dela.
- Esquecer a semente. Sem ela, você não consegue repetir o resultado nem comparar com o de outra pessoa.
- Simular o experimento errado. Se a pergunta é sobre dois dados, sortear um número de 2 a 12 não serve: as somas não têm todas a mesma chance.
- Tirar conclusão de uma rodada só. O valor da simulação muda com a semente. Vale rodar com duas ou três sementes para ver o tamanho da variação.
Agora é com você!
Primeiro no papel. Qual é a chance de sair cara nas duas vezes em dois lançamentos de uma moeda? Liste as combinações possíveis e calcule. Depois, descreva em quatro passos, como os do início do artigo, a simulação que conferiria a sua resposta.
No computador: escreva essa simulação com 10.000 repetições e semente 42. Em seguida, mude a pergunta para uma que você ainda não sabe calcular: qual a chance de a soma de três dados ser 15 ou mais? Tente sozinho, sem pedir a resposta pronta para ninguém, nem para a IA!
Até o próximo artigo!
Confiança Sempre!!!
Fontes:
- Los Alamos National Laboratory, Estados Unidos. Hitting the Jackpot: The Birth of the Monte Carlo Method, com a história da criação do método e a origem do nome.
- Universidade Federal do Rio de Janeiro, Programa de Engenharia de Sistemas e Computação, material de aula. Método de Monte Carlo, com a lei dos grandes números como base do método e o comportamento do erro.
- Universidade de São Paulo, material de aula. Introdução ao Método Monte Carlo, com a simulação, a lei dos grandes números e o cálculo de integrais.
- Instituto de Matemática e Estatística da USP, disciplina MAE5704. Métodos de Monte Carlo I, com a origem do método e a estimativa do erro.
- Instituto de Matemática e Estatística da USP, disciplina MAE 5905. Introdução à Ciência de Dados, aula 20, com a aproximação de uma média pela simulação e o erro padrão da estimativa.
- Universidade Federal de Minas Gerais, Departamento de Estatística, notas de aula. Técnicas de simulação em Estatística, com o algoritmo do método para estimar integrais.
- Universidade Federal do Rio de Janeiro, COPPE, material de aula. Método de Monte Carlo, aula 6, com a estimativa de pi e o cálculo do erro.
- Universidade de São Paulo, disciplina AGA 511. Métodos Computacionais em Astronomia, com a agulha de Buffon e o erro de Monte Carlo.
- Centro Universitário de Volta Redonda, relato de experiência. Encontrando o valor de pi com o Método de Monte Carlo em Python, com os pontos sorteados dentro do quadrado e do círculo.
- Os números deste artigo foram conferidos com as contas exatas (6 em 36 para os dados e a fórmula do problema dos aniversários), e os exemplos foram executados em Python 3.13, PHP 8.3 e GCC 13.
Continue a conversa